Cách sử dụng PLC Data Type và Instance Data Block hiệu quả
Với các dự án S7-1200 quy mô nhỏ, việc khai báo biến rời rạc trong vài Data Block đơn giản có thể chưa gây vấn đề gì. Nhưng khi dự án lớn dần — nhiều động cơ, nhiều van, nhiều trạm giống nhau lặp lại — cách tổ chức dữ liệu sẽ quyết định chương trình của bạn dễ bảo trì hay trở thành một mớ hỗn độn khó kiểm soát. Hai công cụ then chốt để giải quyết bài toán này là PLC Data Type (UDT) và Instance Data Block. Bài viết này sẽ giúp bạn hiểu và dùng đúng cách.
1. PLC Data Type (UDT) là gì?
PLC Data Type — thường được gọi tắt là UDT (User-Defined Type) — là công cụ cho phép bạn tự định nghĩa một cấu trúc dữ liệu để dùng lại nhiều lần trong chương trình, thay vì phải khai báo lặp đi lặp lại từng biến riêng lẻ.
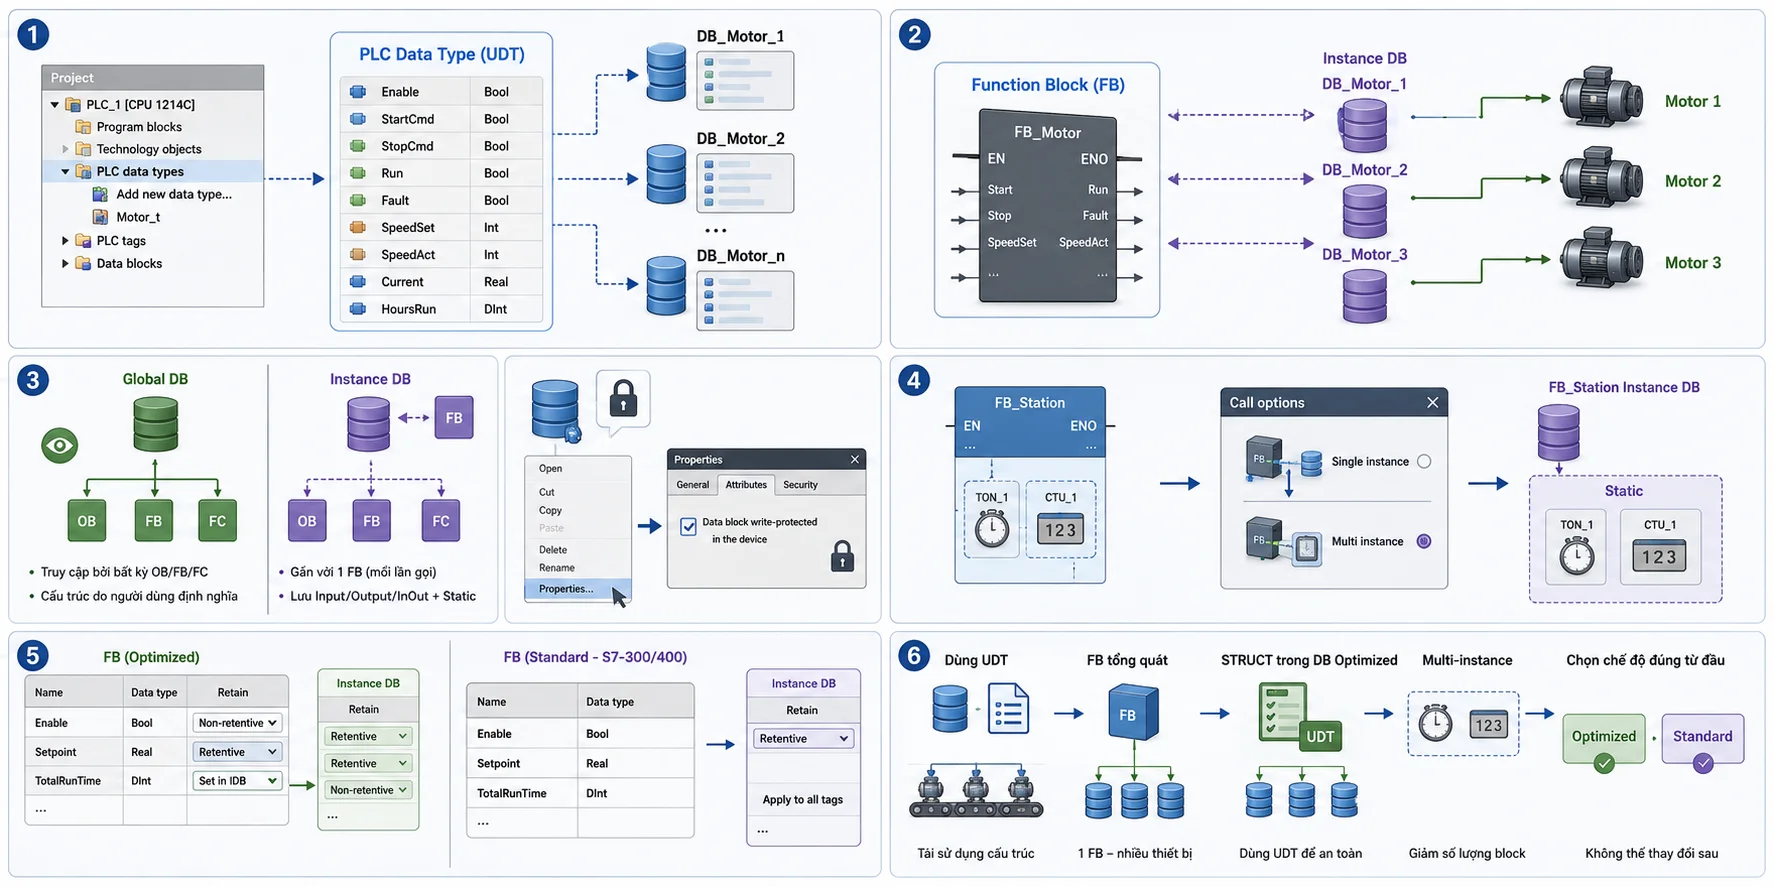
Cách tạo rất đơn giản: mở nhánh "PLC data types" trong cây dự án, double-click vào "Add new data type", sau đó dùng chính công cụ soạn thảo giống như trong DB editor để thêm các dòng dữ liệu cần thiết vào cấu trúc.
Sau khi tạo, tên PLC Data Type mới sẽ xuất hiện trong danh sách chọn kiểu dữ liệu (data type selector) ở cả DB editor lẫn code block interface editor — nghĩa là bạn có thể dùng nó như bất kỳ kiểu dữ liệu có sẵn nào khác.
Ứng dụng thực tế của PLC Data Type
Theo tài liệu, PLC Data Type có hai công dụng chính:
Dùng trực tiếp làm kiểu dữ liệu trong interface của code block hoặc trong Data Block.
Dùng làm khuôn mẫu (template) để tạo nhiều global Data Block có cùng cấu trúc.
Ví dụ điển hình từ tài liệu: một PLC Data Type có thể đại diện cho "công thức pha màu" (recipe for mixing colors). Bạn gán PLC Data Type này cho nhiều Data Block khác nhau — mỗi Data Block sau đó chỉnh sửa giá trị biến riêng để tạo ra một màu cụ thể. Áp dụng vào thực tế công nghiệp, đây chính là cách bạn định nghĩa cấu trúc "một trạm động cơ", "một van", hay "một cảm biến nhiệt độ" — rồi tái sử dụng cho hàng chục thiết bị giống nhau trong dây chuyền.
Lưu ý khi dùng Struct trong DB dạng "Optimized"
Đây là điểm rất dễ gây lỗi khó hiểu cho người mới: nếu bạn dùng kiểu dữ liệu Struct trực tiếp (không qua UDT) trong một DB dạng "Optimized", một số lệnh như READ_DBL/WRIT_DBL sẽ không hoạt động đúng. Bạn bắt buộc phải tạo UDT cho cấu trúc đó trước, rồi cấu hình cả DB nguồn và DB đích cùng dùng UDT này — điều đó đảm bảo kiểu dữ liệu bên trong cấu trúc là hoàn toàn giống nhau giữa hai DB. Với DB dạng "Standard" (tương thích S7-300/400), bạn có thể dùng Struct trực tiếp mà không cần tạo UDT.
2. Instance Data Block là gì và tại sao cần dùng?
Khác với PLC Data Type (dùng để định nghĩa cấu trúc dữ liệu), Instance Data Block (Instance DB) là bộ nhớ đi kèm riêng cho từng lần gọi của một Function Block (FB).
Cơ chế hoạt động: khi bạn gọi một FB, bạn phải chỉ định kèm theo một Instance DB — DB này lưu trữ các tham số Input/Output/InOut và dữ liệu Static của FB đó. Sau khi FB thực thi xong, CPU quay lại code block đã gọi nó, nhưng dữ liệu trong Instance DB vẫn được giữ lại — sẵn sàng cho lần gọi tiếp theo, dù ở cùng vòng quét hay vòng quét khác.
Nói cách khác: FC không có bộ nhớ riêng (dữ liệu tạm sẽ mất sau mỗi lần thực thi), còn FB thì có — nhờ Instance DB đi kèm. Đây là lý do FB thường được dùng cho các tác vụ không thể hoàn thành trong một vòng quét, ví dụ điều khiển động cơ, xử lý giao tiếp bất đồng bộ như USS hay PtP.
Một FB tổng quát, nhiều Instance DB — mô hình tái sử dụng mạnh mẽ
Đây chính là sức mạnh lớn nhất của Instance DB: bạn có thể thiết kế một FB tổng quát (generic) để điều khiển một loại thiết bị, sau đó gọi FB đó nhiều lần với Instance DB khác nhau cho từng thiết bị cụ thể.
Ví dụ từ tài liệu: FB22 được thiết kế để điều khiển động cơ, gọi 3 lần trong một OB với 3 Instance DB khác nhau — DB201 lưu dữ liệu vận hành (tốc độ, thời gian tăng tốc, tổng thời gian hoạt động...) của động cơ thứ nhất, DB202 cho động cơ thứ hai, DB203 cho động cơ thứ ba. Nhờ vậy, bạn chỉ cần viết và kiểm thử logic điều khiển động cơ một lần duy nhất trong FB22, rồi tái sử dụng cho bao nhiêu động cơ tùy ý — chỉ cần tạo thêm Instance DB tương ứng.
3. Global DB và Instance DB: phân biệt rõ hai loại
Đặc điểm | Global DB | Instance DB |
|---|---|---|
Ai có thể truy cập | Bất kỳ OB, FB, FC nào | Về nguyên tắc gắn với một FB cụ thể, nhưng thực tế bất kỳ code block nào cũng đọc/ghi được |
Cấu trúc dữ liệu | Do người dùng tự định nghĩa hoàn toàn | Phản ánh đúng các tham số Input/Output/InOut và dữ liệu Static của FB (không bao gồm Temp) |
Vòng đời dữ liệu | Tồn tại độc lập | Gắn liền với từng "instance" (lần gọi cụ thể) của FB |
Cả hai loại DB đều giữ nguyên dữ liệu sau khi code block liên quan thực thi xong — dữ liệu không bị xóa như với Temp memory.
Mẹo bảo mật dữ liệu: bạn có thể đặt một DB ở chế độ chỉ đọc (write-protected) bằng cách chuột phải vào DB trong project navigator → Properties → Attributes → chọn "Data block write-protected in the device". Cách này hữu ích khi bạn muốn bảo vệ dữ liệu cấu hình quan trọng khỏi bị ghi đè ngoài ý muốn.
4. Multi-instance DB: gộp dữ liệu để giảm số lượng block
Ngoài cách tạo Instance DB riêng cho mỗi lần gọi FB, S7-1200 còn hỗ trợ khái niệm Multi-instance — cho phép "lồng" dữ liệu static của các lệnh có sẵn (như Timer, Counter) vào ngay trong Instance DB của FB cha, thay vì tạo Instance DB riêng cho từng lệnh con.
Ví dụ với Timer hoặc Counter đặt bên trong một FB: khi hộp thoại "Call options" hiện ra, bạn chọn biểu tượng "Multi instance" thay vì tạo DB riêng — cấu trúc dữ liệu của Timer/Counter (như IEC_TIMER, IEC_COUNTER) khi đó sẽ xuất hiện trong phần Static của FB interface. Cách làm này giúp giảm đáng kể số lượng block trong dự án lớn, đồng thời vẫn giữ được khả năng cấu hình từng thuộc tính riêng (ví dụ đánh dấu Retentive cho một Timer/Counter cụ thể).
5. Retentive data với FB: hai chế độ Optimized và Standard
Cách cấu hình dữ liệu duy trì sau mất điện (retentive) cho các tag trong FB phụ thuộc vào việc FB được tạo ở chế độ nào:
FB dạng "Optimized": interface editor có cột "Retain", cho phép chọn từng tag riêng lẻ là Retentive, Non-retentive, hoặc "Set in IDB" (đặt từ Instance DB). Nếu chọn "Set in IDB", bạn chỉ có thể thay đổi trạng thái retentive từ chính Instance DB editor.
FB dạng "Standard - compatible with S7-300/400": interface editor không có cột Retain riêng cho từng tag. Thay vào đó, Instance DB có cột Retain chung — chọn Retentive cho một tag sẽ áp dụng cho toàn bộ các tag, không thể chọn riêng lẻ.
Lưu ý quan trọng: tùy chọn "Standard - compatible with S7-300/400" hay "Optimized" chỉ được chọn một lần duy nhất khi tạo FB và không thể thay đổi sau đó. Vì vậy cần cân nhắc kỹ ngay từ đầu dự án, đặc biệt nếu bạn dự định dùng nhiều Timer/Counter retentive với yêu cầu kiểm soát chi tiết.
6. Một số nguyên tắc thực hành khi tổ chức dữ liệu
Dùng PLC Data Type cho bất kỳ cấu trúc dữ liệu nào lặp lại từ 2 lần trở lên — động cơ, van, trạm cân, cảm biến nhiệt độ... Việc này giúp khi cần sửa cấu trúc (thêm một trường dữ liệu mới), bạn chỉ cần sửa một chỗ duy nhất, thay vì rà soát từng DB.
Thiết kế FB càng tổng quát càng tốt, tách biệt phần logic điều khiển (đặt trong FB) khỏi dữ liệu riêng của từng thiết bị (đặt trong Instance DB) — đây chính là nguyên tắc lập trình hướng đối tượng áp dụng vào PLC.
Luôn dùng UDT khi làm việc với Struct trong DB "Optimized", đặc biệt nếu chương trình có dùng READ_DBL/WRIT_DBL để sao chép dữ liệu giữa các DB.
Cân nhắc dùng Multi-instance cho các lệnh phụ trợ như Timer, Counter khi số lượng block trong dự án bắt đầu trở nên khó quản lý.
Xác định chế độ Optimized/Standard cho FB ngay từ đầu dự án, vì không thể đổi lại sau này.
Kết luận
PLC Data Type và Instance Data Block không chỉ là các khái niệm kỹ thuật đơn thuần — chúng là công cụ tổ chức chương trình theo hướng module hóa, giúp một dự án S7-1200 quy mô lớn vẫn giữ được cấu trúc rõ ràng, dễ mở rộng và dễ bảo trì. Đầu tư thời gian thiết kế đúng cấu trúc dữ liệu ngay từ giai đoạn đầu dự án sẽ tiết kiệm rất nhiều công sức khi hệ thống phát triển thêm thiết bị hoặc chức năng mới về sau.